相机可控的Image2Video方法
梳理近期读到的camera control I2V方法,面向驾驶世界模型
首先定义我们的任务:
输入首帧 $I_0$ 及一段相机位姿 $T_{i=1}^N$,我们希望输出一段从首帧出发的,视点变化与所输入相机位姿一致的视频
世界模型方法
这类方法没有专门针对“相机控制”去做优化,通常采用单一的生成损失,条件控制作为生成能力训练中学习到的一种附加条件,因此往往控制效果一般。
Vista, NeurIPS 2024
GEM, CVPR 2025
Epona, ICCV 2025
GenieDrive, CVPR 2026 两阶段生成,先生成4D占据,再用4D占据引导视频生成
OmniNWM, ECCV 2026 用归一化Plucker参数缓解几何协变量偏移
相机优化方法
MotionCtrl
CameraCtrl, ICLR 2025 重点讨论了
- 相机如何表示,plucker嵌入
- 相机姿势如何注入
这两点也成了后续诸多工作的改进点
结构非常简单,损失依旧是生成损失
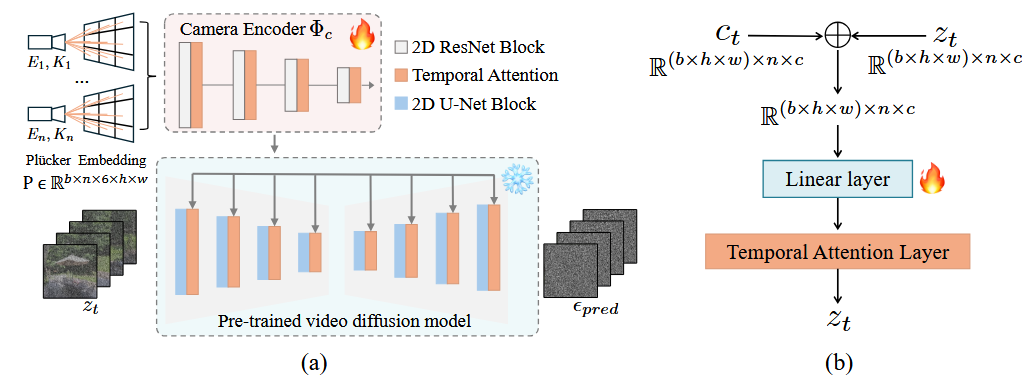 CameraCtrl II
针对动态性调整了相机注入方式,但是训练方式没有变化
CamI2V
- 相机位姿如何表示? 类似于CameraCtrl, 使用plucker射线多尺度编码嵌入
- 如何注入扩散模型? 引入了对极注意力 生成依旧用的生成损失 $$ \mathcal{L} = \mathbb{E}{z_0,t,\epsilon}\left[\left|\epsilon-\epsilon\theta\left(z_t,t,c_{\mathrm{img}},c_{\mathrm{txt}},c_{\mathrm{cam}}\right)\right|_2^2\right] $$
Campilot,
如何训练相机控制的?
在模型生成的视频潜变量后面,接一个3D解码器,结合相机位姿输出3DGS,以及对应轨迹的渲染视图,
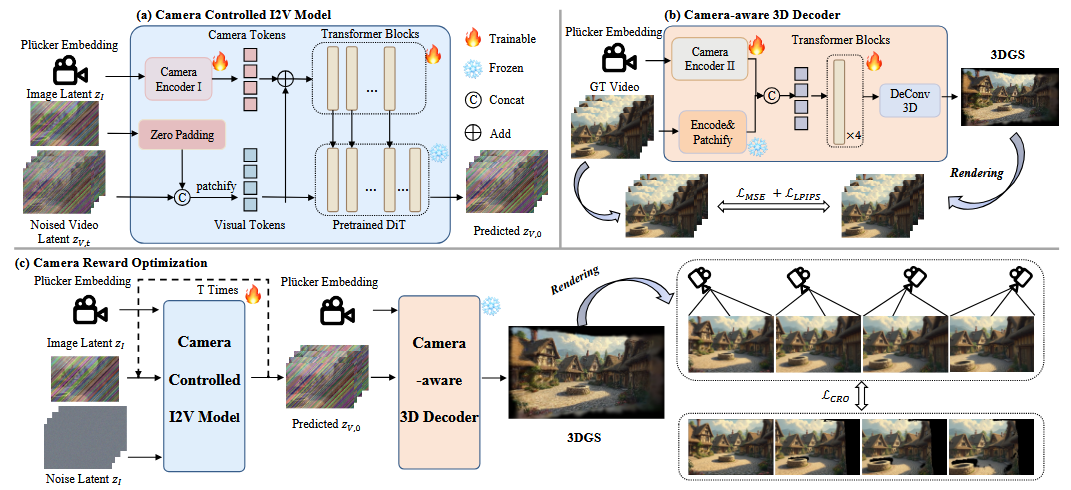
不清楚,视频latent直接解码为视频,和3D解码器解码的视频,有什么不同?除了论文中提到的解码速度快
PosePilot, IROS 2025
创新是“几何读出模块+三个辅助损失”这一整套训练机制。 PosePilot(Jin 等, 2025)保留原世界模型的生成目标,再加入深度、运动估计及相应监督,使生成过程受到几何约束,从而改善相机位姿控制。 引入三项损失: $$L_{total} = L_g + \alpha_p L_p + \alpha_{p^{inv}} L_p^{inv} + \alpha_{mse}L_{MSE}$$
TriMotion
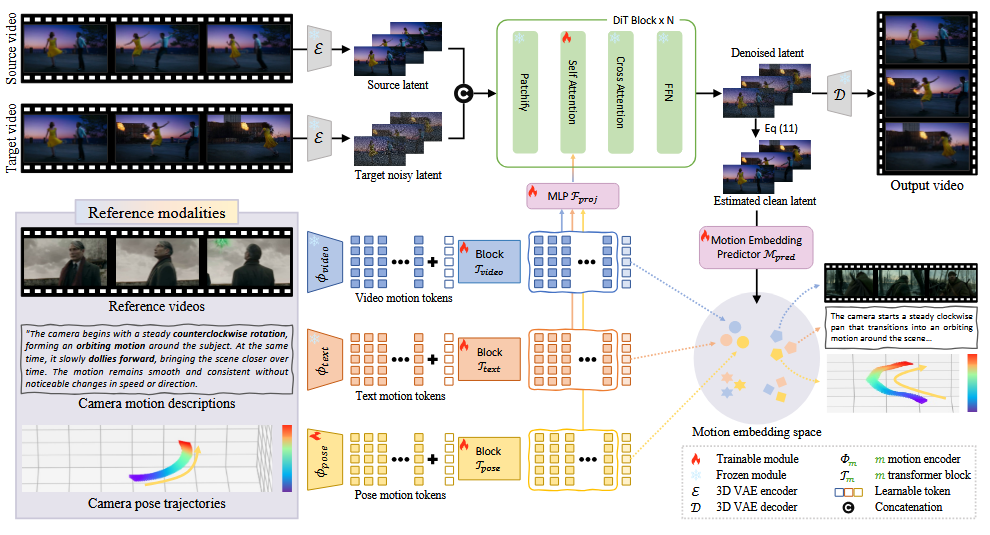 首先训练出一个轨迹预测器,能够从视频潜变量中编码运动嵌入$e_m$ , 用该嵌入和统一运动空间中的运动嵌入做监督,同时监督运动轨迹和生成质量
好奇:运动空间的嵌入有什么物理意义吗,又如何精确引导相机轨迹?
Training-Free方法
CamProbe, 如果我们把扩散模型 从采样阶段约束,而不是从生成阶段